Introduction
Les intervalles de confiance sont un passage délicat du programme de probabilités en ECG. Ce chapitre arrive souvent en fin d’année, et les élèves peinent à distinguer les différentes méthodes de construction (Bienaymé-Tchebychev vs. théorème central limite) et à interpréter correctement les résultats.
Ce document reprend l’intégralité du cours avec des explications pas à pas, des exemples concrets et un tableau comparatif des méthodes. Vous y trouverez également un formulaire récapitulatif avec les trois formules clés à maîtriser pour les concours.
Pourquoi les intervalles de confiance ?
Lorsqu’on réalise un sondage ou une expérience, on cherche souvent à estimer un paramètre inconnu  (par exemple, la proportion
 de personnes favorables à une mesure).
À partir d’un échantillon 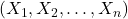 , on peut calculer un estimateur ponctuel
 de . Mais donner une seule valeur ne suffit pas : on a besoin de savoir à quel point cette estimation est fiable.
L’idée clé
Un intervalle de confiance est un intervalle aléatoire  qui « capture » le vrai paramètre avec une probabilité contrôlée. Par exemple, dire « est dans
 avec une confiance de
 » est beaucoup plus informatif que de dire simplement «
 ».
Plan du chapitre :
- Définition d’un intervalle de confiance
- Construction par l’inégalité de Bienaymé-Tchebychev
- Intervalle de confiance pour la moyenne (loi normale,
 connu)
- Intervalles de confiance asymptotiques et théorème central limite
1. Intervalle de confiance : définition
1.1 Cadre général
On se place dans le cadre classique de l’estimation :
- on dispose d’un -échantillon
 de loi dépendant d’un paramètre
 ;
- on souhaite estimer une fonction
 du paramètre ;
- on cherche deux statistiques
 et
 telles que tombe dans
 avec une probabilité au moins
 .
 et
 telles que
Intervalle de confiance
Soit ![\alpha\in\,]0,1[](https://prepasmaths360.com/wp-content/ql-cache/quicklatex.com-7569c72c9a60a0489de264a562be6e28_l3.png "Rendered by QuickLaTeX.com") . Soient
 et
 deux estimateurs de
 tels que, pour tout
 :

On dit que l’intervalle est un intervalle de confiance de au niveau de confiance au moins  (ou avec un risque d’au plus
 ).
1.2 Vocabulaire et conventions
Bien comprendre les termes
- est le risque (ou seuil de signification) : c’est la probabilité maximale de « rater » le vrai paramètre.
- est le niveau de confiance : c’est la probabilité minimale de capturer .
- En pratique, on utilise souvent
 (confiance
 ) ou
 (confiance ).
 (confiance
 ).
⚠ Attention : ce que ça ne veut pas dire
Un intervalle de confiance à ne signifie pas que « a de chances d’être dans l’intervalle ». Le paramètre est fixe (mais inconnu). C’est l’intervalle qui est aléatoire : si on répétait l’expérience un grand nombre de fois, environ des intervalles construits contiendraient le vrai paramètre.
1.3 En pratique
Concrètement, on part d’un échantillon observé  et on calcule :
 et
 . L’intervalle numérique
 est une réalisation de l’intervalle aléatoire : c’est elle que l’on communique.
2. Construction par l’inégalité de Bienaymé-Tchebychev
2.1 Rappel de l’inégalité
Inégalité de Bienaymé-Tchebychev
Soit une variable aléatoire admettant une variance. Pour tout  :

2.2 Construction de l’intervalle
Idée : on part de l’inégalité de Bienaymé-Tchebychev et on la « retourne » pour obtenir un encadrement de .
Étape 1 : en passant au complémentaire, on obtient :
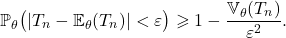
Étape 2 : si est un estimateur sans biais de , c’est-à-dire  , on obtient :
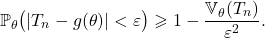
Étape 3 : si l’on peut choisir  (ou
 ) tel que
 , alors :

Méthode : intervalle via Bienaymé-Tchebychev
Si est un estimateur sans biais de , l’intervalle de confiance est :

avec déterminé par la condition .
2.3 Exemple : estimation de p pour une loi de Bernoulli
Sondage : intervalle pour le paramètre p
Contexte. On réalise un sondage auprès de personnes. Chaque personne répond oui (1) ou non (0) de manière indépendante, avec probabilité de répondre oui. On note  la réponse de la
 -ème personne.
Modèle. Chaque suit une loi de Bernoulli  , et les sont indépendantes. On a :
 et
 .
Estimateur naturel. On utilise la moyenne empirique 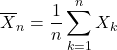 . C’est un estimateur sans biais de , et :
 ,
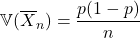 .
Application de Bienaymé-Tchebychev. L’inégalité donne :  .
L’astuce clé. Le problème est que  dépend de , qui est inconnu ! On utilise alors le fait que
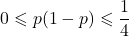 pour tout
 , ce qui donne la majoration :
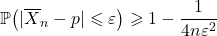 .
Choix de . On veut que le membre de droite soit égal à , donc : 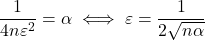 .
Conclusion. L’intervalle de confiance de au niveau est :
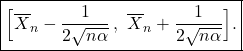
Application numérique. Pour  et
 :
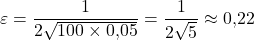 . On obtient l’intervalle
 avec un niveau de confiance de .
Remarque : cet intervalle est assez large (amplitude 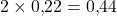 , soit une marge de
 autour de
 ) ! C’est le prix à payer pour n’utiliser que l’inégalité de Bienaymé-Tchebychev, qui est très générale mais peu précise. On verra que le théorème central limite permet de faire beaucoup mieux.
3. Intervalle de confiance pour la moyenne d’une loi normale
3.1 Cadre et hypothèses
On se place maintenant dans un cadre plus précis : on connaît la loi des observations.
Hypothèses :
 est un -échantillon issu d’une loi normale
 ;
- l’écart type est connu ;
- l’espérance
 est inconnue : c’est elle que l’on cherche à estimer.
3.2 La moyenne empirique et sa loi
La moyenne empirique est un estimateur sans biais et convergent de  . Grâce à la stabilité de la loi normale par combinaison linéaire, on sait que :

En centrant et réduisant, on obtient la variable pivot : 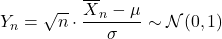 .
3.3 Construction de l’intervalle
Soit  le réel tel que
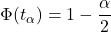 , où
 est la fonction de répartition de
 .
Rappel : quantile de la loi normale
Le réel  vérifie :
 .
Valeurs courantes :
| Risque | 0,05 | 0,01 | 0,10 |
|---|---|---|---|
| Confiance | 95 % | 99 % | 90 % |
| ≈ 1,96 | ≈ 2,58 | ≈ 1,645 |
Dérivation pas à pas. On part de  . En remplaçant
 par
 et en isolant :

Intervalle de confiance – loi normale, σ connu
Sous les hypothèses ci-dessus, l’intervalle de confiance de au niveau est :

Application numérique
On mesure la taille de  étudiants. On suppose que la taille suit une loi
 avec
 cm (connu). On observe
 cm.
Pour un niveau de confiance de (,  ) :
 cm.
L’intervalle de confiance est 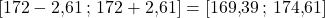 .
Interprétation : on est confiant à que la taille moyenne des étudiants se situe entre  cm et
 cm.
Observations importantes
- Quand augmente, l’intervalle rétrécit (sa longueur est proportionnelle à
 ) : plus on a de données, plus on est précis.
- Quand on augmente la confiance (on diminue ), l’intervalle s’élargit (
 augmente) : plus on veut être sûr, moins on est précis.
- Il y a donc un compromis entre la confiance et la précision.
 ) : plus on a de données, plus on est précis.
4. Intervalles de confiance asymptotiques
4.1 Motivation
Dans l’exemple précédent, on a eu la chance de connaître la loi exacte de . En pratique, on ne connaît pas toujours la loi exacte de l’estimateur. C’est là qu’intervient le théorème central limite (TCL), qui donne une approximation de la loi pour grand.
Le prix à payer : le résultat n’est qu’asymptotique, c’est-à-dire valable « quand est assez grand ».
4.2 Définition
Intervalle de confiance asymptotique
Soit . Soient et deux estimateurs de tels que, pour tout :
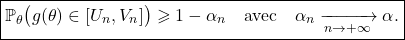
On dit que est un intervalle de confiance asymptotique de avec un risque d’au plus (ou au niveau de confiance au moins ).
Différence avec l’IC exact
Pour un intervalle de confiance exact, la probabilité 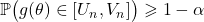 est vraie pour tout . Pour un IC asymptotique, la probabilité est
 avec
 : la garantie n’est parfaite que quand est grand.
4.3 Exemple phare : intervalle asymptotique pour p (loi de Bernoulli)
Intervalle asymptotique pour le paramètre p
On reprend le même modèle de sondage que précédemment :  i.i.d. de loi .
Étape 1 – Loi de la somme. Par indépendance :  (loi binomiale).
Étape 2 – Application du TCL. Le théorème central limite donne :
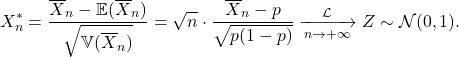
Étape 3 – Encadrement. Soit tel que 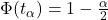 . On a :
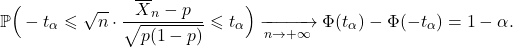
En isolant , on obtient l’intervalle :
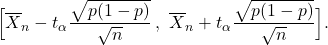
Étape 4 – Éliminer . Le problème est que les bornes dépendent encore de (qu’on ne connaît pas). On utilise encore  :
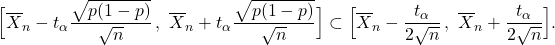
Par croissance de la probabilité, on en déduit : 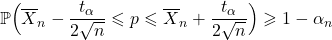 avec .
Conclusion. L’intervalle de confiance asymptotique de au niveau est :
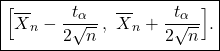
Application numérique. Pour () et  :
 . L’intervalle est
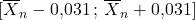 , soit une marge de
 points de pourcentage. C’est bien plus précis que l’intervalle par Bienaymé-Tchebychev !
5. Synthèse et comparaison des méthodes
| Bienaymé-Tchebychev | TCL (asymptotique) | |
|---|---|---|
| Hypothèses | Très faibles (existence de la variance) | assez grand |
| IC pour (Bernoulli) |  |  |
| Pour , | |  |
| Précision | Faible (intervalle large) | Bonne (intervalle étroit) |
| Validité | Exacte pour tout | Approximative (bonne dès  ) |
Morale
L’inégalité de Bienaymé-Tchebychev est un outil universel mais peu précis. Dès que est assez grand, on préfère utiliser le TCL pour construire des intervalles asymptotiques beaucoup plus étroits. En pratique, c’est le TCL qui est systématiquement utilisé dans les sondages.
6. Formulaire récapitulatif
Formules à retenir
1. Loi de Bernoulli , méthode de Bienaymé-Tchebychev :
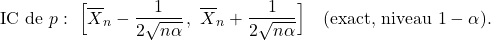
2. Loi normale ,  connu :

3. Loi de Bernoulli , méthode du TCL :

Quantiles usuels de :  ;
 ;
 .
Télécharger le cours en PDF
Pour réviser sur papier, téléchargez le chapitre complet au format PDF.