
↩ Chapitre : Dénombrement et probabilités (MP)
L’essentiel des variables aléatoires discrètes au programme officiel de MP.
1. Cadre
- Dénombrabilité :
 ,
 ,
 dénombrables,
 non ; réunion dénombrable d’ensembles dénombrables.
- Tribu ; probabilité
 -additive. Continuité croissante :
 ; décroissante : . Sous-additivité :
 ; une réunion dénombrable de négligeables est négligeable. Probabilités totales (système complet ou quasi-complet dénombrable) :
 ; Bayes :
 .
- Distribution de probabilités discrète (famille positive de somme
 , support au plus dénombrable) ; existence d’espaces portant des suites i.i.d. (pile ou face infini).
 ,
 ,
 dénombrables,
 non ; réunion dénombrable d’ensembles dénombrables.
 -additive. Continuité croissante :
 ; décroissante :
 . Sous-additivité :
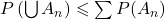 ; une réunion dénombrable de négligeables est négligeable. Probabilités totales (système complet ou quasi-complet dénombrable) :
 ; Bayes :
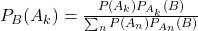 .
 , support au plus dénombrable) ; existence d’espaces portant des suites i.i.d. (pile ou face infini).
2. Lois et indépendance
- Loi
 , loi conditionnelle, loi conjointe et marginales ; indépendance (familles finies et quelconques),
 ; lemme des coalitions : si
 sont mutuellement indépendantes, toute fonction de
 est indépendante de toute fonction de
 .
 :
 ,
 ,
 ;
 :
 .
 , loi conditionnelle, loi conjointe et marginales ; indépendance (familles finies et quelconques),
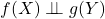 ; lemme des coalitions : si
 sont mutuellement indépendantes, toute fonction de
 est indépendante de toute fonction de
 .
 :
 ,
 ,
 ;
 :
 .
Espérance, variance, génératrices
 : somme de la famille
 (sommable pour
 ) ; à valeurs dans
 :
 ; transfert ; domination ;
 si indépendantes.
 ; Cauchy-Schwarz
 ; variance nulle
 constante p.s. ; covariance, variance d’une somme.
- Markov :
 ,
 . Bienaymé-Tchebychev :
 . Loi faible des grands nombres : si
 est i.i.d. de variance finie,
 ,
 , alors
 .
 : rayon
 , convergence normale sur le disque unité fermé ; caractérise la loi ;
 ;
 si indépendantes.
 : somme de la famille
 (sommable pour
 ) ; à valeurs dans
 :
 ; transfert ; domination ;
 si indépendantes.
 ; Cauchy-Schwarz
 ; variance nulle
 constante p.s. ; covariance, variance d’une somme.
 ,
 . Bienaymé-Tchebychev :
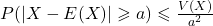 . Loi faible des grands nombres : si
 est i.i.d. de variance finie,
 ,
 , alors
 .
 : rayon
 , convergence normale sur le disque unité fermé ; caractérise la loi ;
 ;
 si indépendantes.
À savoir sur le programme
Variables à densité, espérance conditionnelle et convergences (presque sûre, en probabilité, en loi) sont hors programme.
3. Pièges classiques
 n’exige pas que
 et
 soient définies sur le même espace, mais n’implique pas .
- Décorrélées n’implique pas indépendantes.
 n’exige pas que
 et
 soient définies sur le même espace, mais n’implique pas
 .